Para rodar IA local no PC, o que mais pesa é a memória: de preferência a da placa de vídeo, e na falta dela a RAM do computador. Um assistente pequeno, de uns 8 bilhões de parâmetros, cabe numa placa com 8 GB e responde bem para texto do dia a dia. A NPU, apesar da fama, ajuda pouco nesse uso. Ela cuida dos recursos de IA do próprio Windows, e os programas de assistente local rodam na placa de vídeo ou no processador.
Nuvem ou local: o que muda para você
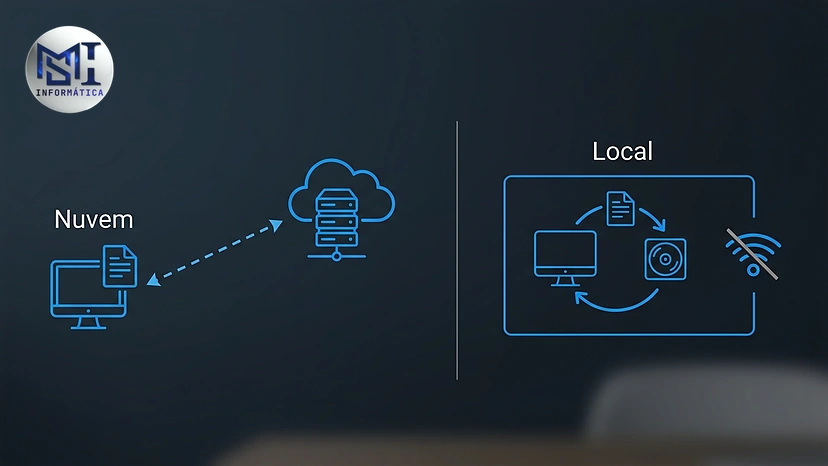
ChatGPT, Copilot e Gemini rodam nos servidores das empresas. Funcionam em qualquer PC com navegador, são mais capazes e não pedem nada do hardware. O preço é que o texto que você digita sai do computador.
No modelo local, o programa e o “cérebro” ficam no seu disco. Nada sai da máquina, funciona sem internet e não tem mensalidade. Em troca, o modelo é menor, responde com menos profundidade e depende do seu hardware.
Para quem trabalha com dado de cliente, a diferença pesa. Contrato, cadastro e conversa de atendimento colados num assistente local não passam por servidor de terceiro, e isso simplifica a conta da LGPD. Os usos de IA no atendimento estão no post sobre IA para atendimento na pequena empresa.
O programa instalado no meu PC
No meu PC, o assistente local instalado é o Ollama, um programa gratuito que baixa e executa modelos de linguagem no Windows, no Linux e no Mac. Quando rodei o winget para conferir atualizações em 09/10/2026, ele apareceu na lista, na versão 0.40.0, com a 0.40.2 disponível.
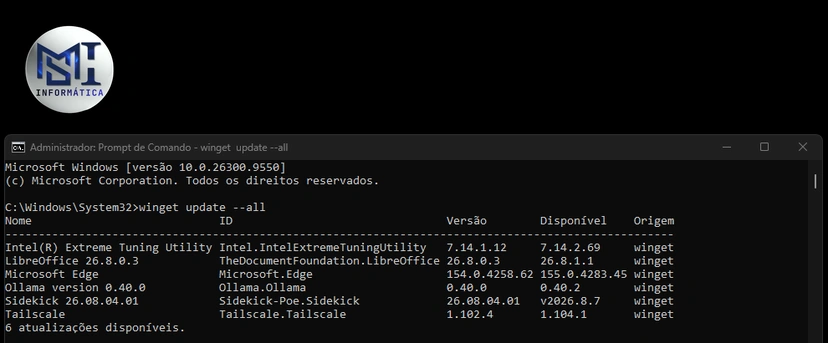
O Ollama não é o único. Há outros programas com janela mais amigável, e todos fazem a mesma coisa por baixo: carregam um modelo na memória e respondem pelo processador ou pela placa de vídeo. A escolha do hardware vale para qualquer um deles.
A conta da memória
Um modelo de linguagem é medido em bilhões de parâmetros (o “8B” do nome quer dizer 8 bilhões). Na versão comprimida mais usada, cada parâmetro ocupa cerca de meio byte. Some uma folga para a conversa e você tem uma estimativa de quanta memória o modelo pede:
| Tamanho do modelo | Memória aproximada | Onde cabe |
|---|---|---|
| 3B a 4B | 3 GB a 4 GB | Placa de 4 GB, ou RAM de 16 GB |
| 7B a 8B | 5 GB a 6 GB | Placa de 8 GB |
| 12B a 14B | 9 GB a 10 GB | Placa de 12 GB |
| 30B a 32B | 20 GB ou mais | Placa de 24 GB |
São números de conta, não medição. O tamanho exato aparece na página de cada modelo antes do download.
Placa de vídeo ou RAM
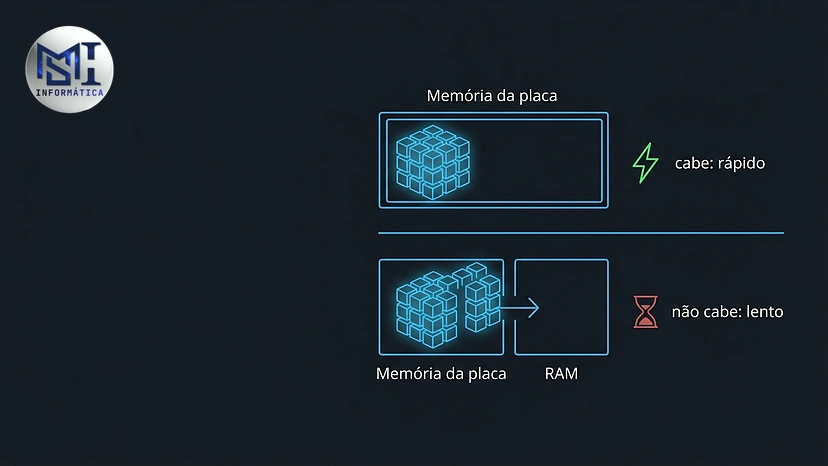
Se o modelo cabe inteiro na memória da placa, a resposta sai rápida. Se não cabe, o programa joga parte dele para a RAM e o processador assume, e a velocidade cai muito. Funciona, mas a resposta pode levar o tempo de um café.
Nem toda placa serve. A documentação do Ollama aceita placas NVIDIA com capacidade de computação 5.0 ou mais nova, o que inclui a série GTX 900 e as seguintes, com driver recente. Do lado AMD, no Windows, a lista vai da RX 7600 à RX 7900. Placa fora da lista ainda roda o programa, só que pelo processador.
E a NPU?
A NPU dos notebooks Copilot+ PC, que a Microsoft exige com 40 TOPS ou mais, roda as legendas ao vivo, os efeitos de câmera e a busca do Windows. A documentação do Ollama não cita NPU. Para um assistente de conversa, quem trabalha é a placa de vídeo ou o processador. O que a NPU faz de verdade está explicado em notebook com NPU.
Três perfis, três respostas
Quem tem PC gamer com placa de 8 GB ou mais já tem o hardware. Instale o programa, baixe um modelo de 7B ou 8B e teste com as suas tarefas. Se a resposta não for boa o bastante, a nuvem continua ali.
Quem tem notebook de escritório sem placa dedicada, com 16 GB de RAM, consegue rodar modelos de 3B ou 4B pelo processador. Servem para resumir texto e reescrever e-mail, sem pressa. Com 8 GB de RAM, o Windows e o navegador já ocupam boa parte, e a experiência fica ruim. O porquê está em quanto de memória RAM você precisa.
Quem pensa em comprar uma placa só para IA deve olhar primeiro a memória dela, e só depois o desempenho em jogo. Uma placa com mais memória roda modelos maiores, mesmo sendo mais lenta. Os outros critérios estão no guia de como escolher placa de vídeo.
Para saber em qual perfil você está, abra o Gerenciador de Tarefas, vá em Desempenho e anote dois números: a memória total e, se houver, a “Memória dedicada da GPU” da placa de vídeo. Com eles na mão, a tabela da memória mostra o tamanho de modelo que o seu PC aguenta antes de você baixar qualquer coisa.
Conteúdo original produzido pela MSI Informática, com captura de tela própria; texto organizado e revisado com apoio de ferramenta de IA. A memória por tamanho de modelo é estimativa de cálculo, não teste. Placas suportadas conforme a documentação do Ollama consultada em 09/10/2026. Antes de colar dado de cliente em qualquer assistente, confira a política de dados da empresa.
Comentários
Os comentários passam por aprovação